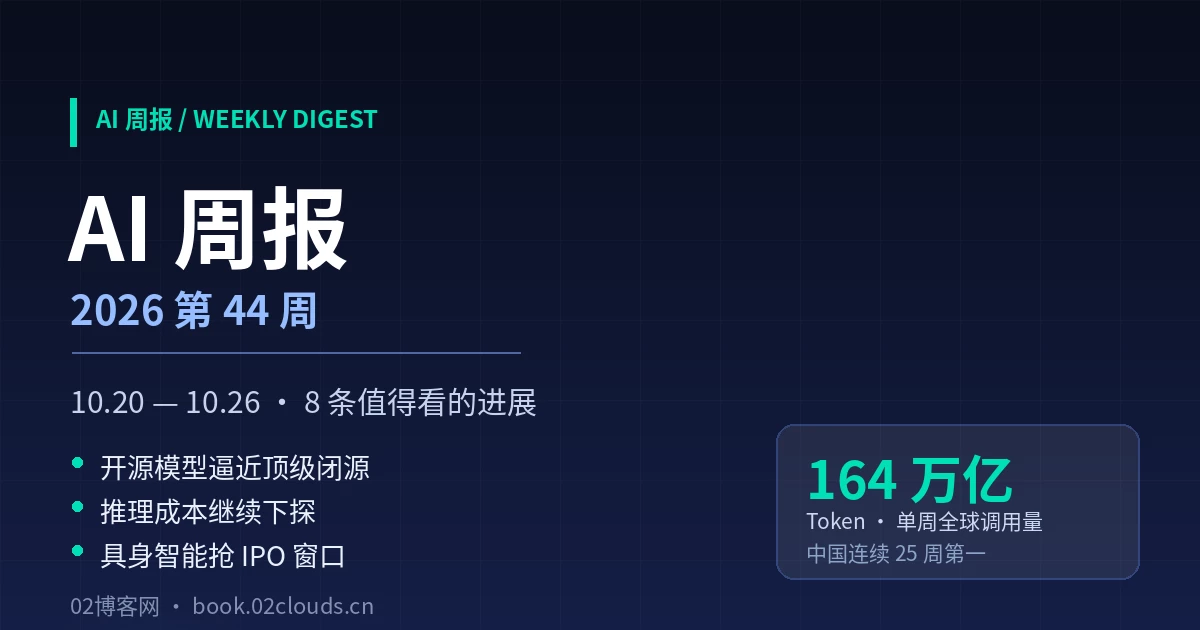

AI摘要:本周AI领域发生多件重要事件:Kimi K3.1 Pro开源,参数规模达3万亿级;科大讯飞星火X2.6发布,重点在国产算力上完成训练;MiniMax M3.1 Flash开源,成本降低70%,速度提升近3倍;火山引擎Seedance 2.5 4K发布,冲影视工业;DeepSeek融资1000亿元人民币,上市准备中;OpenAI模型进入Google Cloud;可灵Kling 4.0上线,小米开源空间音频模型;具身智能抢IPO窗口。
本周三条主线同时发生:开源模型把顶级闭源的能力拉到几乎齐平、推理成本继续往下砸、资本开始给具身智能定价。
8 条进展,每条都附原文链接,方便你自己追。
先说一个背景数字:据 OpenRouter 统计,10 月 12 日至 18 日全球 AI 大模型总调用量为 164 万亿 Token,中国大模型的周调用量已连续 25 周 超过美国,当周全球调用量排名前五全部是中国模型。(来源:中新社)
1. Kimi K3.1 Pro:3 万亿参数,继续做全球最大开源模型
10 月 24 日凌晨,月之暗面发布 Kimi K3.1 Pro,参数规模 3 万亿级,支持 100 万 Token 上下文,继续保住「全球参数规模最大开源模型」的位置。它是今年 7 月 Kimi K3(2.8 万亿参数)的后训练版本,强化学习算力投入大幅增加。
官方强调的提升集中在代码、3D 创作、金融研究和长程 Agent 能力上;在多项国际评测中,官方称其综合智能已接近全球领先的闭源模型。完整权重将于 11 月 4 日前对外发布。价格方面,人民日报客户端给出的说法是「约为 OpenAI GPT-6 Astra 模型的五分之一」。
值得注意的点:这一代的关键词不是「堆参数」,而是「后训练」——K3 到 K3.1 的增量几乎全部来自强化学习环节的算力投入和训练框架优化。参数规模正在变成入场券,后训练和推理效率才是分水岭。
来源:人民日报客户端 · 中新社(腾讯新闻转载)
2. 科大讯飞星火 X2.6:重点是「在国产算力上完成训练」
10 月 22 日,2026 科大讯飞全球 1024 开发者节在北京开幕,刘庆峰发布端云一体的讯飞星火 X2.6,同时带来星火语音基座大模型 SparkAudio 1.0、星火具身多模交互技术等产品。
星火 X2.6 采用 293B 总参数 / 30B 激活的 MoE 架构,支持 100 万 Token 上下文,已部署在国产万卡推理集群上。官方数据:长程任务动态并行训练让超长上下文训练效率提升约 4 倍,自适应存算协同推理让推理效率提升 4.5 倍,端云路由准确率提升至 96.1%。
为什么这条重要:刘庆峰的原话是「不仅要能够在国产算力上进行推理,更要能够在国产平台上完成训练」。过去一年国产芯片更多承担推理,这次是往训练环节迈了一步。同场还发布了星辰 TaaS 平台(模型调度 + 智能体引擎 + 工具编排)和 AIPC 产品线,灵机 N9000 提供 160 TOPS 本地 AI 算力。
来源:新华网安徽 · Global Times(英文,含参数细节)
3. MiniMax M3.1 Flash 开源:成本降七成,速度翻近三倍
10 月 23 日,MiniMax 宣布开源 M3.1 Flash。相较上一代 M3,使用成本降低约 70%,线上推理速度提升近 3 倍,官方称上线 72 小时处理超过 100 万亿 Token。优化手段包括全模型稀疏注意力、量化感知训练和 Power-aware scheduling。华为昇腾等国产平台首日接入。
看点:这轮国产模型的竞争焦点,已经从「榜单第几名」转到「一个 Agent 任务跑完要花多少钱」。降价 + 提速,直接把 Agent 类应用的门槛又砍了一截。
4. 火山引擎 Seedance 2.5 4K:开始冲影视工业
10 月 23 日,火山引擎发布视频生成模型 Seedance 2.5 4K,定位大银幕场景,是 Seedance 2.5 这一代里最强的版本。支持 Draft 样片模式——先用 480P 验证分镜、调整镜头,确认后再生成 4K 正片;画质支持 10-bit 色深。
目前不公开发售,首批以作品绑定方式定向供应全球 20 家工作室和导演,最早下月会有卫视 S 级 IP 剧集播出。
看点:「先低成本试错、再出正片」这个工作流,才是 AI 视频真正进入剧组的关键——不是生成得多漂亮,而是能不能嵌进既有的制片流程里。
来源:创业家周报
5. DeepSeek:千亿级融资 + 上市准备(尚未官宣)
据 10 月 23 日多家媒体报道,DeepSeek 新一轮融资规模约 1000 亿元人民币(约 150 亿美元),投前估值维持在约 5000 亿元 水平;腾讯控股与宁德时代是出资最多的投资方,联想控股旗下君联资本、石溪资本、吉利等产业资本也在名单中。同步推进的是上市准备:公司已聘请中信证券提供 IPO 顾问服务,9 月引入新的首席财务官,最快可能在 2027 年初推进 IPO。
⚠️ 需要注意:以上均为「知情人士」消息,DeepSeek 与相关投资方均未公开确认。
看点:如果数字成立,这已经不只是融资,而是把一家模型公司当成国家级 AI 基础设施在定价。
来源:21 世纪经济报道·AI 周报 · 创业家周报
6. OpenAI 的模型,进了 Google Cloud
10 月 21 日,OpenAI 与 Google Cloud 宣布合作,把 GPT-6 Astra、GPT-6.1 Sol、GPT-6 Luna 以及 Codex 的智能体工作流接入 Google Cloud 的模型目录 Model Garden。目前是对部分企业客户的私有预览,正式开放预计在「未来几周」。
这意味着两件事:GPT 成为继 Claude 之后第二个同时登陆 AWS、Azure、Google Cloud 三大公有云的模型;而 Google Cloud 成了唯一同时提供 GPT、Claude、Gemini 三家顶级模型的云。采购走 Google Cloud Marketplace,费用可冲抵已有的云消费承诺。OpenAI 同时强调微软仍是其最核心的云伙伴。
看点:企业客户要的从来不是「最强模型」,而是「在我已经签了合同的那朵云里能选到合适的模型」。这一单的胜负手在采购流程,不在跑分。
来源:韩联社(含三家模型定位)
7. 可灵 Kling 4.0 上线,小米开源空间音频模型
可灵 4.0:新一代视频生成模型上线,面向高动态、强运镜场景,支持单次最长 30 秒原生视频生成、多关键帧控制与多素材参考,具备 4K、10-bit HDR 画质与原生立体声,重点解决了大幅度动作稳定性和运镜流畅度。
小米 MiDashengLM-Spatial(10 月 15 日):端到端空间音频理解大模型开源,在保留基础音频理解能力的同时新增空间感知与推理能力,将陆续用于智能家居、汽车座舱。
看点:一条往「画面质量」卷,一条往「多一种感官」卷。视频模型拼 4K 和时长只是上半场,带声音、带空间感才是下一层。
来源:北京市科委·一周企业动态
8. 具身智能开始抢 IPO 窗口
- 松延动力以保密形式向港交所递交上市申请,拟募资数亿美元,最快 2027 年挂牌。这家公司靠 9998 元的人形机器人「小布米」出圈,创始团队来自清华、浙大,宁德时代参与投资。
- 银河通用与宇树科技宣布联合研发全球首个原生智能体机器人「银河星仔 GalbotET1」,该产品 8 月已在世界机器人大会上首次亮相,此次是双方正式确认联合研发。
看点:继宇树之后,又一家人形机器人公司进入 IPO 通道。机器人赛道正在从「发布会比谁翻跟头稳」,转入「比谁能先拿到公开市场的钱」。
来源:21 世纪经济报道·AI 周报 · 澎湃新闻
本周一句话总结
把这一周连起来看,答案很清楚:「谁的参数更大」已经不再是主线。开源阵营用 Kimi K3.1 Pro 和 MiniMax M3.1 Flash 把「接近顶级闭源 + 便宜一大截」变成了常态;讯飞把训练搬上国产算力;视频模型开始按剧组的工作流改造自己;而千亿资金和 IPO 排队,说明资本已经在为下一层——具身智能——提前定价。
对普通开发者来说,最直接的信号是:同等预算能跑的 Agent 任务,比三个月前多了一大截。
本文由 02博客网整理,事件均标注原始来源,传闻类信息已明确标记。转载注明出处。



暂无评论内容